脆弱拟杆菌(Bacteroides fragilis)是拟杆菌门中一类严格厌氧的革兰氏阴性杆状细菌,广泛存在于人类结肠中,约占肠道菌群总量的1%[1-2]。该菌株具有出众的碳水化合物降解能力,能够利用宿主难以消化的膳食纤维和黏蛋白,产生短链脂肪酸(如乙酸丙酸和丁酸),对维持肠道屏障完整性、抑制病原菌生长及调节宿主免疫功能发挥不可替代的作用[3-5]。
近年来宏基因组学与代谢组学的飞速进展使人们逐步意识到脆弱拟杆菌在炎症性肠病(inflammatory bowel disease,IBD)代谢综合征及肿瘤免疫中的双重角色[6-8]。研究表明该菌株能够依托表面糖分子与免疫球蛋白A(immunoglobulin A,IgA)结合,激活宿主的适应性免疫系统从而在结肠上皮黏膜中稳定定殖[9];代谢产物被验证与宿主的代谢调节紧密关联,尤其在糖尿病和结肠炎等疾病的治疗中展现出潜在的应用价值[10-11]。
虽然脆弱拟杆菌在维持肠道微生态平衡方面有重要意义,但其复杂代谢网络及在不同碳源条件下的代谢情况尚未取得系统且全面的解析[12-13],传统实验方法受限于高通量筛选的难度,难以快速评定该菌株对数百种潜在碳源的利用潜力,为突破这一瓶颈基因组代谢工程技术应势出现,基因组规模代谢网络模型(genome-scale metabolic model,GSMM)通过整合基因组注释信息,构建出一个宏观且精细的代谢网络[14],能够系统性地预测微生物在特定环境下的生长表型和代谢产物生成情况。
目前,虽然已有研究者,如Neal等[15]构建了包含上千个反应的脆弱拟杆菌代谢模型(如iMN674),但其仍存在局限性,依赖单一基因组背景、碳利用能力被高估,这些缺陷限制了其在探索菌株特异性代谢行为和碳源适应性方面的应用价值。因此,构建一个基于最新基因组注释信息、具有高准确性和预测能力的代谢网络模型,已成为深入解析脆弱拟杆菌代谢行为、筛选优质益生菌菌株的关键技术手段。
本研究旨在构建脆弱拟杆菌的全基因组尺度代谢网络模型,并基于该模型系统评估其碳源利用能力。研究将依托基因组功能注释,整合完整的编码基因集、代谢物及反应信息,构建结构化的代谢网络模型。通过模型质量评估与定性验证,解析脆弱拟杆菌在不同碳源条件下的代谢特征,为其在益生菌开发及肠道疾病干预中的应用提供理论依据。
1 材料与方法
1.1 实验材料
1.1.1 菌株
脆弱拟杆菌AR1538,上海理工大学食品生物技术研究所菌种库。
1.1.2 试剂
BHI培养基,青岛高科技工业园海博生物技术有限公司;D-(+)-木糖、L-木糖、L-(+)阿拉伯糖、D-(-)阿拉伯糖、DL-阿拉伯糖、木糖醇、D-阿拉伯糖醇、异麦芽酮糖、D-甘露醇、DL木糖、L-(-)山梨糖、L-(-)-阿拉伯糖醇、乳糖醇、L-鼠李糖、D-(+)纤维二糖、D-山梨醇、菊糖、麦芽糖、乳糖、D-(+)蔗糖、D-(+)-半乳糖、糖原、甘露低聚糖、D-果糖、D-棉子糖、低聚半乳糖、乳果糖、海藻糖、半乳糖醇(卫矛醇)、低聚木糖、D-阿洛酮糖、D-核糖、D-葡萄糖、L-(-)-岩藻糖、麦芽糖醇、木聚糖,上海源叶生物科技有限公司。
1.1.3 仪器与设备
ML204分析天平、pH计,梅特勒-托利多仪器上海有限公司;SpectraMax i3x多功能酶标仪,美谷分子科技有限公司;725型紫外分光光度计,光谱仪器有限公司;LRH-70型恒温培养箱,上海一恒科学仪器有限公司;Centrifuge 5430R冷冻离心机,Eppendorf公司。
1.2 实验方法
1.2.1 单菌基因组注释
将实验室保存的脆弱拟杆菌AR1538菌株从-80 ℃甘油管中取出,在脑心浸出液(brain heart infusion,BHI)固体培养基上37 ℃厌氧活化48 h,挑取单菌落接种至5 mL BHI固体培养基37 ℃培养36 h,再以2%的接种量接至50 mL BHI培养基中静置培养36 h至对数中期(OD600=1.0±0.3)。菌液经10 000 r/min离心10 min收集菌体,用预冷PBS(pH 6.5)洗涤3次以彻底去除培养基残留,最终留下菌泥。全基因组测序委托商业机构使用Illumina +PacBio的测序方式,获得的高质量基因组FASTA。快速注释工具(apid annotation using subsystem technology,RAST)是一种用于对完整或近乎完整的细菌与古菌基因组进行自动注释的生物信息学工具[16]。可系统预测基因组的开放阅读框(open reading frame,ORF)、rRNA、tRNA及其功能基因,并支持代谢网络的构建。注释时,用户需将基因组序列上传至RAST服务器,在获取注释结果后,可将预测的蛋白组序列下载至本地,供后续功能分析与代谢建模使用。
1.2.2 草图模型的构建
文件直接上传至gapseq软件进行自动化模型构建。gapseq是一种用于通路分析和代谢网络重建的新型软件,其通路分析预测是基于多个生物化学数据库,这些数据库包含有关通路结构、关键酶和反应化学计量学的信息[17]。软件首先调用MetaCyc、KEGG及ModelSEED数据库进行通路预测:通过DIAMOND比对(e-value<1e-10)识别与代谢反应相关的酶编码基因,当某通路中≥70%反应存在序列证据时判定该通路存在;同时基于转运蛋白分类数据库(transport protein classification database,TCDB)识别碳源转运系统。整合上述结果生成初始草案模型。
1.2.3 模型的修正与验证
将软件默认培养基替换为实验用BHI配方,删除原葡萄糖交换反应,添加候选碳源(包括木糖、菊粉、甘露糖等)的交换反应(通量范围设定为-5~0 mmol/g DCW/h)。通过COBRApy执行通量平衡分析(flux balance analysis,FBA),约束条件为厌氧环境(氧摄取通量上限=0 mmol/g DCW/h),以生物量反应BIOMASS最大化为目标函数。判定碳源可利用的标准为:该碳源摄取通量<-1.0 mmol/g DCW/h且生物量通量>0.06 h-1。再在μ≥0.9×μ_Glc约束下最大化γ-氨基丁酸(γ-aminobutyric acid,GABA)比合成速率,为后续工业筛选提供量化依据。
为了系统识别并修正模型构建过程中可能出现的能量循环、化学计量异常及代谢物生成不合理等错误,本研究采用FBA对初步代谢模型进行检验。首先,在无外源碳底物条件下,通过FBA计算模型内还原当量与能量分子的最大合成通量,若结果非零则表明模型中存在非生理性循环或反应设置错误,需进行相应修正;在有特定碳源条件下,预测所有含碳代谢物的理论最大产率,对超出合理范围的预测路径进行调整。在此基础上,进一步结合不同碳源培养条件下的发酵实验数据,将实际测得的代谢物产率与模型预测结果进行比对,通过模型预测、实验验证、迭代修正的优化过程,逐步提升模型的生理相关性与预测准确性,最终构建出能够可靠模拟细胞代谢行为的基因组尺度代谢网络模型。
1.2.4 模型质量测试
对gapseq得到的模型,计算了SBML模型文件的MEMOTE分数,以评估模型的可靠度。MEMOTE是一种标准代谢网络模型验证工具,通过模型的一致性和注释对模型进行评估。MEMOTE工具要求在Python 3以上环境中使用,并通过pip指令即可直接安装最新版本MEMOTE。在模型路径中运行MEMOTE的指令即可自动开始模型检验,最后会输出.html格式的报告,供生物学家分析与评估。
1.2.5 碳源利用实验
为校正模型预测准确性,开展96孔微孔板碳源生长实验:在超净台中制备含180 μL基础BHI(无碳源)的微孔板,每孔加入20 μL过滤除菌的碳源母液(终质量浓度20 g/L),覆盖26种候选碳源;接种5 μL菌悬液,设置无碳源阴性对照、葡萄糖阳性对照及无菌空白对照(各3重复)。37 ℃厌氧静置48 h,分别测OD600。对比观察培养基的变色情况,向培养后的培养基中加入0.5 g/L溴甲酚紫溶液,培养基中的碳源可被目标菌株利用,则培养基变为黄色,表述菌株被利用会产生酸性代谢产物使pH值降低,不能被利用的培养基仍为紫色。
2 结果与分析
2.1 基因组功能注释与草图模型的获得
实验室完成了AR1538的全基因组测序工作,并通过RAST完成基因组注释。RAST注释共识别出4 975个具有功能注释的基因,其中约20%可被归入27个已知功能子系统,主要涉及蛋白质代谢和碳水化合物代谢等基础代谢过程;其余基因尚未被纳入现有子系统框架,AR1538可能具有较强的物种特异性和未被充分挖掘的代谢潜力。在分布的子系统中(图1),“蛋白质代谢”和“碳水化合物”代谢系统分布的基因序列数目最多,分别为181个和180个。而“氨基酸及其衍生物”以及“辅助因子,维生素,辅基,色素”类别分别包含179和138个基因序列,排在靠前的位置,反映出AR1538可能具备环境特异性适应策略,具有未开发的代谢潜力;在碳源利用与蛋白质处理方面有较强能力。
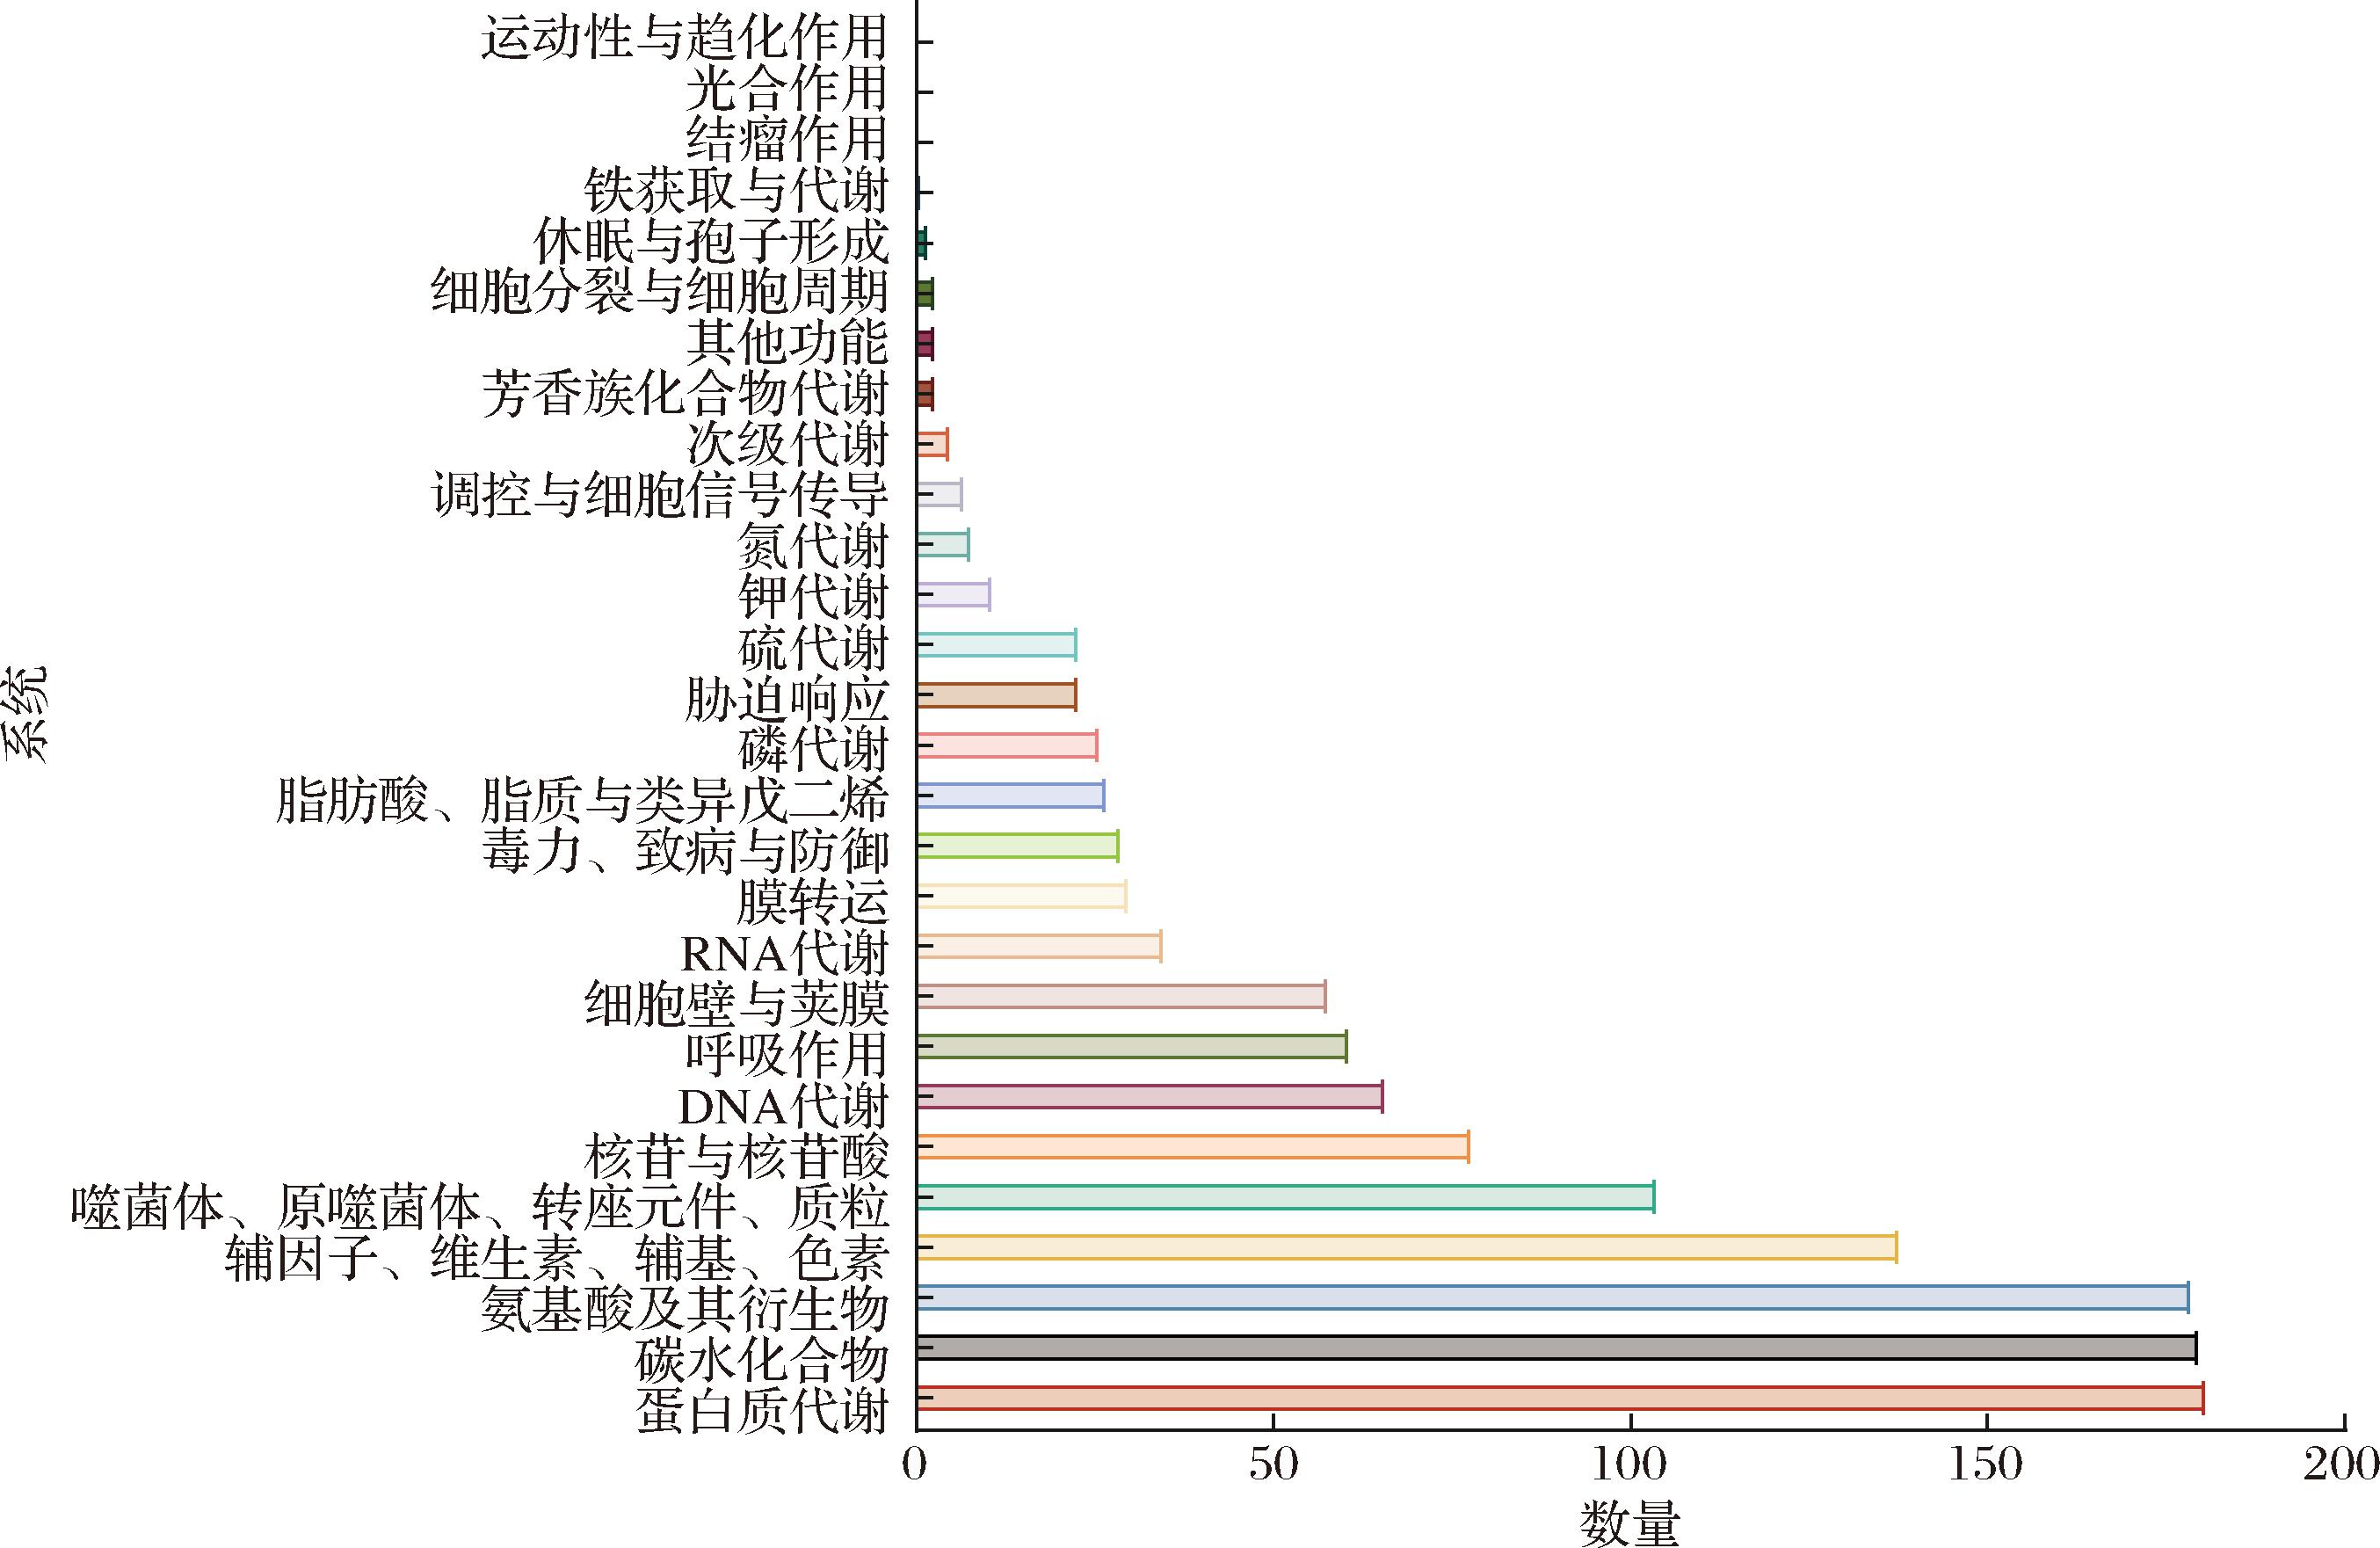
图1 AR1538基因组编码序列子系统分布
Fig.1 Distribution of subsystems in the AR1538 genome-encoded sequences
模型导入MATLAB依据上文所述的方法转换为S(m×n)矩阵,矩阵中m行代表代谢物的数量,n列代表反应的数量,这样S(m×n)矩阵就将代谢物与反应联系起来变为数学矩阵。S(1 645×2 031)表示该GSMM含有1 645个代谢物和2 031个反应。模型中有628个基因,依据命名规则将构建完成的GSMM命名为iBF628。导入MATLAB后的视图如图2所示。其中左列为其指代物的缩写,右列为其值以及值的类型,“mets”表模型中的代谢物;“metsNames”储存了所有代谢物的缩写形式;“metFormulas”表征所有代谢物的化学式;“rxns”代表模型的所有反应;“rxnNames”表示所有反应的名称;“subSystems”表示所有反应归属的代谢亚系统类型;“lb”和“ub”表征每个反应的上下限,其中上下限范围为[-1 000,1 000];“rules”表示反应与基因之间的关联性;“genes”表示模型中所有的基因。
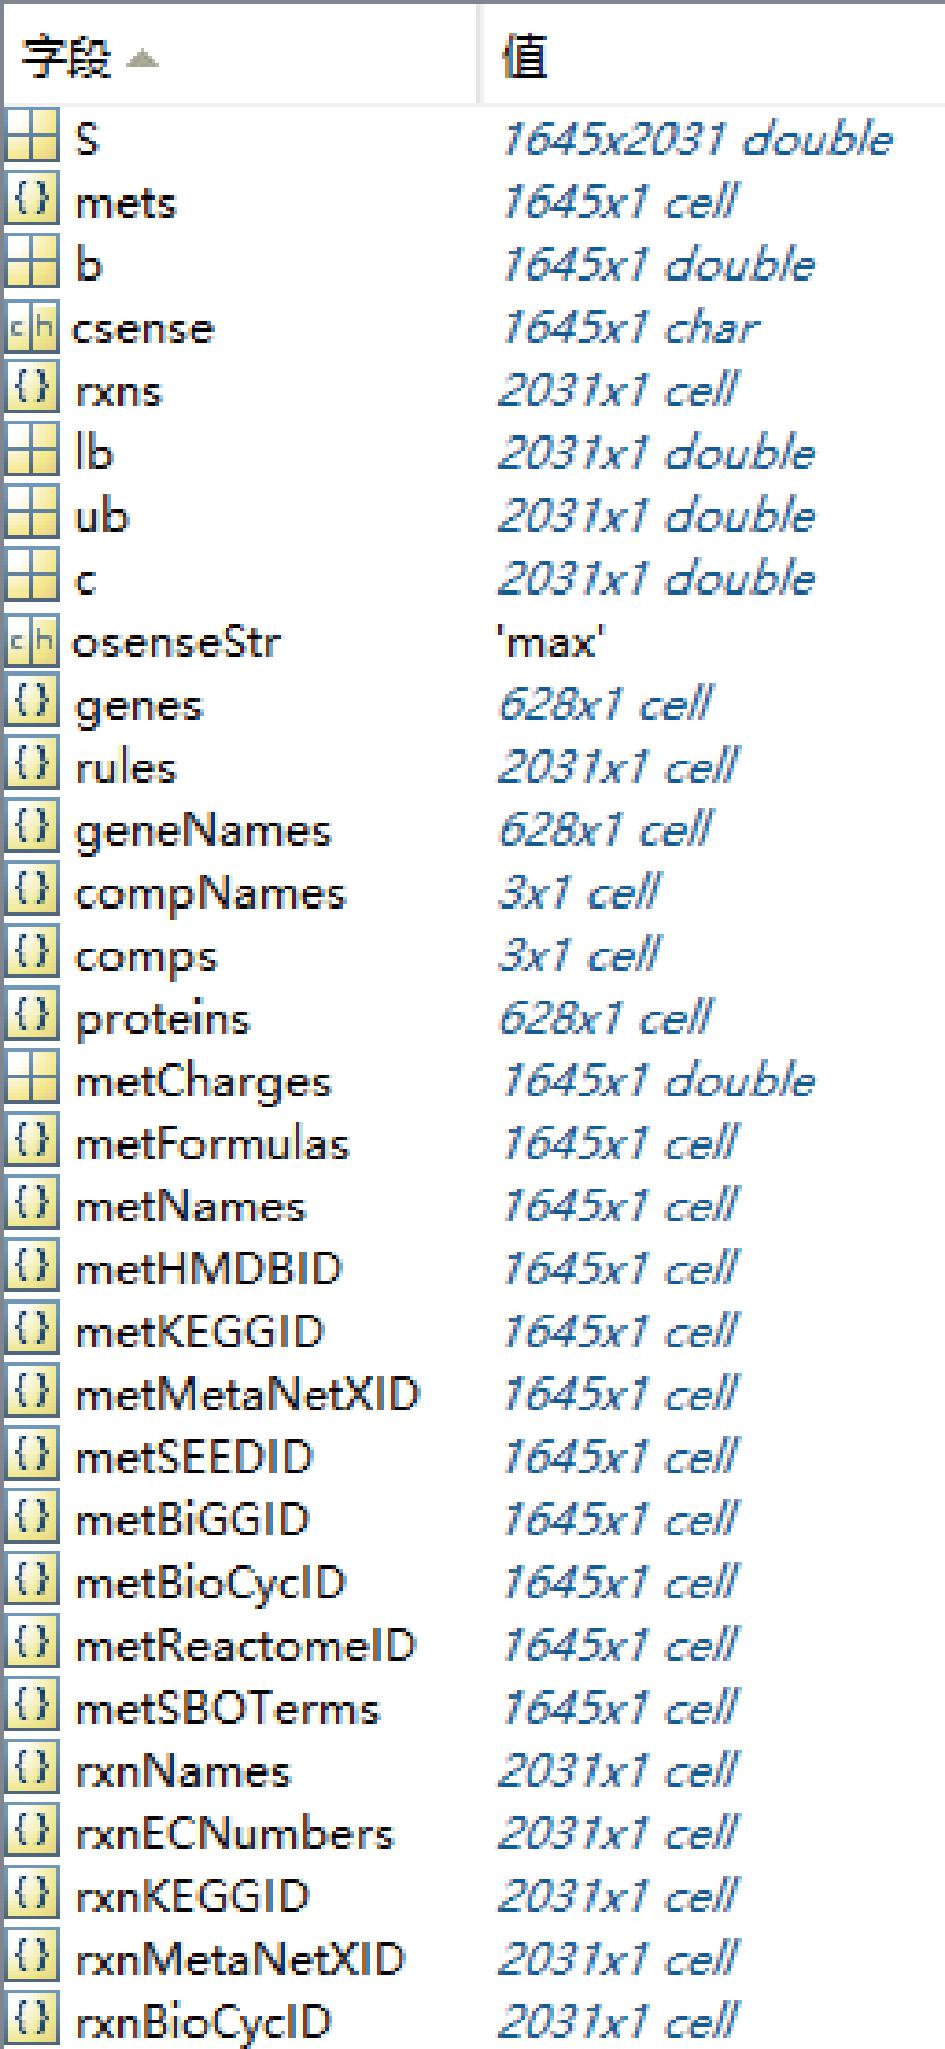
图2 模型iBF628基本信息
Fig.2 Basic Information of Model iBF628
2.2 对不同碳源的可用性进行模型改进和验证
脆弱拟杆菌不仅能代谢利用多种糖类和碳源,其代谢路径和调控机制受到多糖利用基因簇、外界可利用的碳源以及特定代谢调节子的高度调控。这种高度适应性的代谢能力是其在复杂肠道环境中生存和竞争的关键因素。乳酸菌属发酵可利用的主要碳源有葡萄糖、纤维二糖、果糖、半乳糖、乳糖、麦芽糖、蔗糖[18]。将26种碳源底物作为唯一碳源进行定性实验。使用iBF628利用FBA算法对26种唯一碳源的利用能力及主要产物乙酸的生成进行预测。
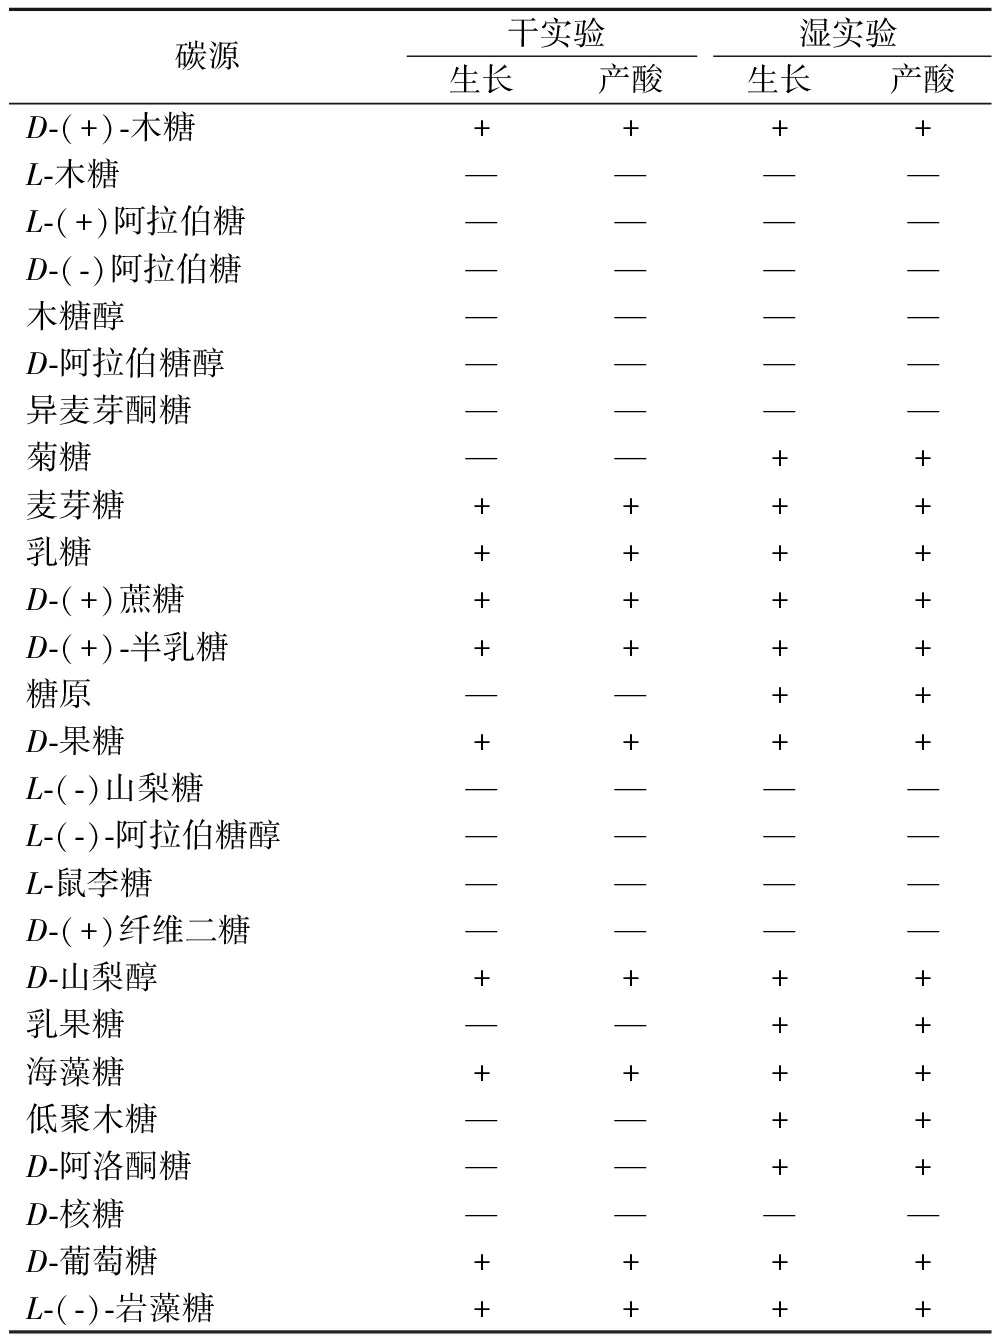
通过模型的预测和“湿实验”的验证,进一步对模型的准确性进行评估(表1),将模型中出现假阳性的碳源进行筛查,删除不可利用的碳源的相关反应,使模型更加精确,修正后的模型准确率为81%。表明修正后的模型iBF628能够比较准确预测菌体利用不同碳源进行代谢生长和产物生成,但是存在部分假阳性的结果(图3),与实验对比可以发现大部分的假阴性是多糖(如菊糖、糖原),通过对模型进行深入分析,发现目前多糖利用基因簇(PULs)的注释及相应反应路径并不完整,这主要体现在菊糖与糖原等特定多糖的降解过程中,相关的水解酶、转运蛋白及修饰反应可能因基因组注释局限或代谢路径数据库覆盖不全而未能被完整纳入。此外,模型对复杂多糖降解的级联反应模拟也略显不足,这类多糖的利用通常涉及多步胞外酶解、寡糖转运以及胞内进一步降解等环节,而当前的FBA模型可能过度简化了这一多步骤、多区室的反应网络,导致难以准确模拟从多糖到可代谢单糖/二糖的完整转化过程。调控机制方面也存在局限性,实际生理条件下特定多糖的利用常受到转录调控(如底物诱导表达)或代谢物效应物(如中间产物积累抑制)的调节,若模型中未引入相应调控约束,可能低估菌株在对应培养条件下的代谢能力。最后,实验条件与模型培养基成分之间存在细微差异,例如实验所用多糖的纯度、聚合度及溶解状态可能与模型假设的理想底物不同,同时实验过程中可能提供了微量激活因子或辅因子,这些并未在模型培养基中设定,从而可能在实验中额外支持了多糖的利用过程。模型在预测多糖利用方面仍较为薄弱,所以需要通过实验来进行脆弱拟杆菌碳源利用的补充,最后修正的模型含有1 645个代谢物和2 026个反应。
表1 干实验与湿实验碳源利用情况
Table 1 Carbon source utilization in dry and wet experiments
碳源干实验湿实验生长产酸生长产酸D-(+)-木糖++++L-木糖————L-(+)阿拉伯糖————D-(-)阿拉伯糖————木糖醇————D-阿拉伯糖醇————异麦芽酮糖————菊糖——++麦芽糖++++乳糖++++D-(+)蔗糖++++D-(+)-半乳糖++++糖原——++D-果糖++++L-(-)山梨糖————L-(-)-阿拉伯糖醇————L-鼠李糖————D-(+)纤维二糖————D-山梨醇++++乳果糖——++海藻糖++++低聚木糖——++D-阿洛酮糖——++D-核糖————D-葡萄糖++++L-(-)-岩藻糖++++
注:“+”表示可生长或产酸,“—”表示不可生长或不产酸。
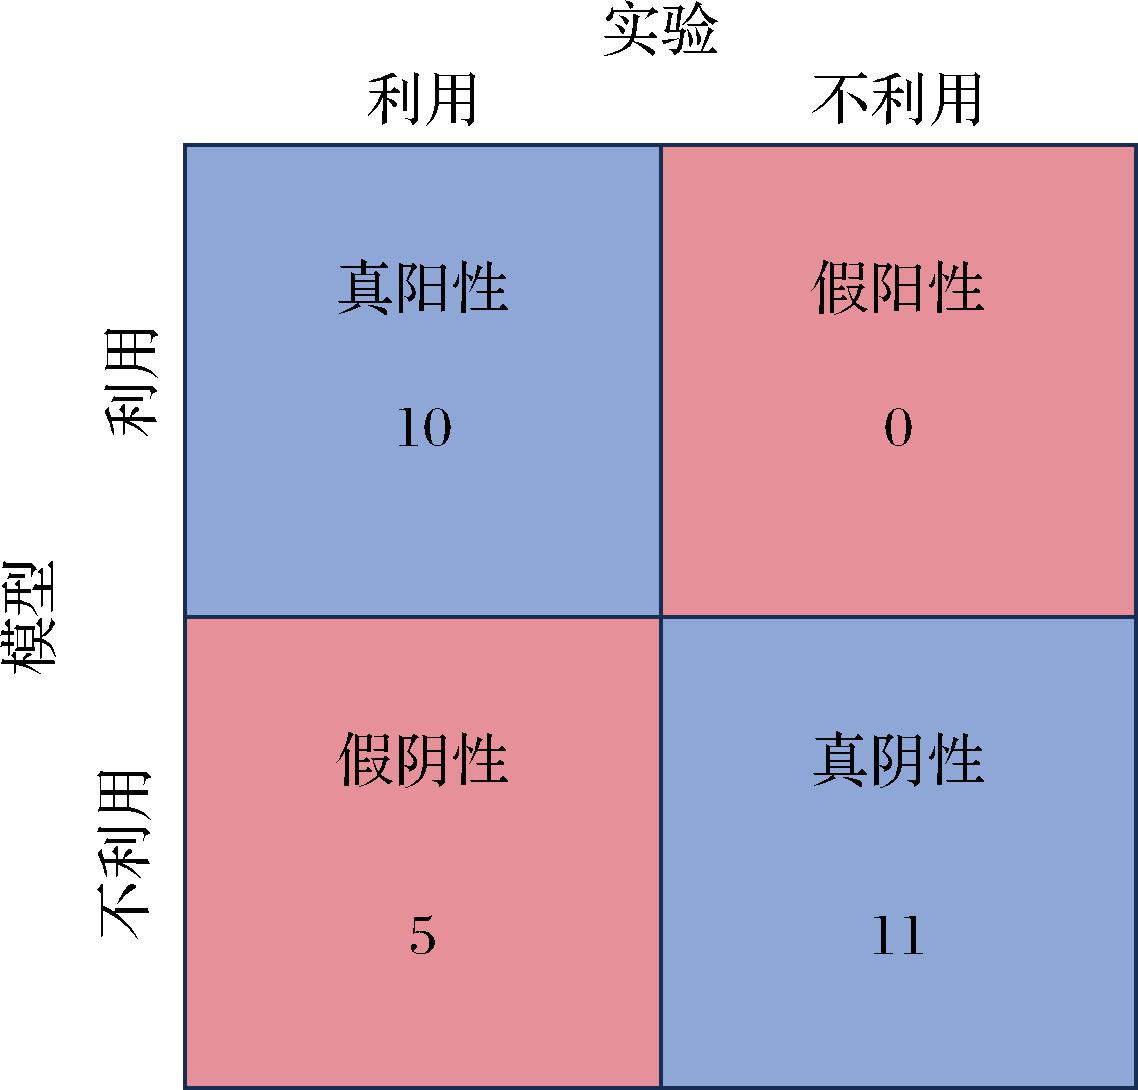
图3 预测结果与实验之间的混淆矩阵
Fig.3 Confusion matrix between predicted results and experimental data
2.3 模型的测试评估
基因组规模代谢模型测试工具(metabolic model testing,MEMOTE)是一款专门用于对基因组尺度代谢网络模型(genome-scale metabolic models,GEMs)进行标准化的质量评估[19],主要功能包括利用系统生物学标记语言(systems biology markup language,SBML)文件格式对模型的注释完整性、化学计量学一致性(包括质量平衡和电荷平衡)、生物量反应产物生成能力以及反应网络的整体连通性进行自动化测试与评分,解决代谢建模领域长期存在的模型可比性差和重建规范不统一的问题。因此,借助MEMOTE对AR1538现有模型进行验证和打分并比较,模型得分达到88.45%,最终结果如图4所示。
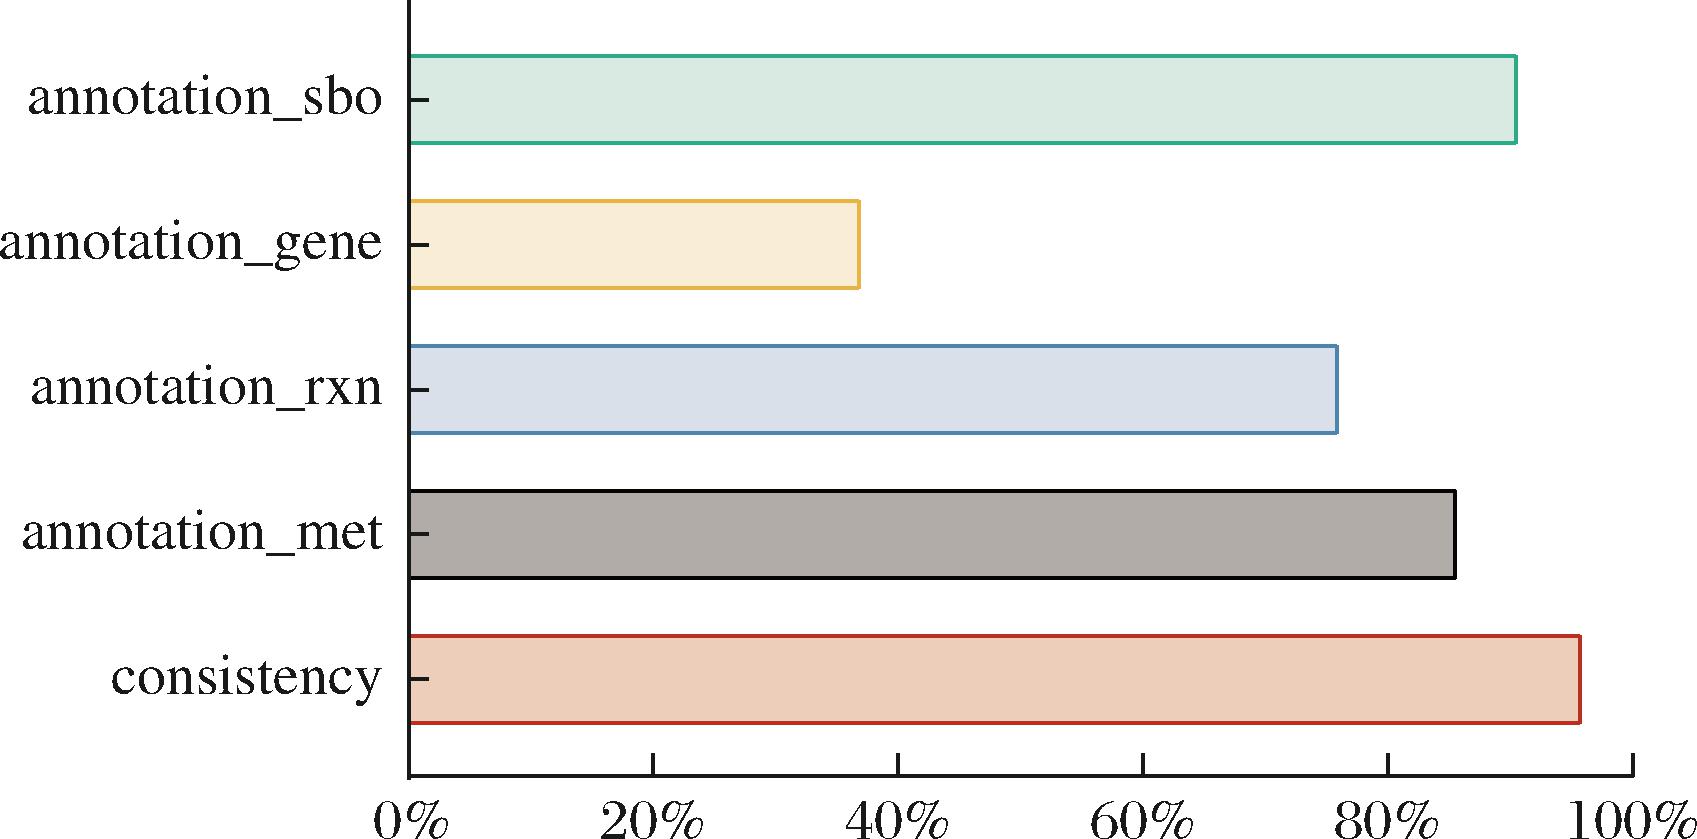
图4 MEMOTE得分
Fig.4 MEMOTE Score
在本文中构建的脆弱拟杆菌AR1538的GEM被命名为iBF628,包含628个基因、1 645个代谢物和2 026个代谢反应。iBF628的化学计量比一致率为100%,大于99%(表2)。说明模型均受到充分约束,代谢反应计量基本一致,产生的代谢物基本守恒,没有从无到有地产生质量,也没有从模型中损耗质量。质量平衡方面,iBF628为100%,大于99%,说明模型内代谢反应两侧的净质量基本相等。
表2 模型测试评估结果
Table 2 Model testing and evaluation results

模型细节代谢物数代谢反应数基因数化学计量比一致率/%质量平衡/%电荷平衡/%代谢物连通率/%代谢物注释率/%代谢反应注释率/%总分/%iBF6281 6452 02662810010010010085.8776.2388.45
2.4 模型碳源利用的预测与分析
预测结果的代谢途径解析,为进一步理解预测结果,对所有预测可利用碳源涉及的代谢途径进行了富集分析。结果显示,通过模型大规模的预测(表3)以及2.2节的结果可以筛选出D-木糖、D-葡萄糖、D-甘露糖、麦芽糖、蜜二糖等17种可利用的碳源。当模型添加上唯一可利用的碳源时,中心碳代谢通量(如丙酮酸脱氢酶与异柠檬酸脱氢酶)及能量转换系统(ATP合酶相关反应)均高于无碳源组,且各代谢模块通量呈比例协同增长,展现出代谢网络的高效性与协调性。在无碳源饥饿条件下,生长几乎停滞,生长速率为0.005 7,代谢状态发生根本转变:关键反应方向反转(如丙酮酸脱氢酶由正转负、异柠檬酸脱氢酶由负转正),三羧酸循环(tricarboxylic acid cycle,TCA cycle)功能可能由产能转为回补合成;同时,内源储备分解途径被激活,质子动力系统则持续运行以维持基础膜电位。
表3 模型碳源利用预测结果
Table 3 Model prediction results for carbon source utilization
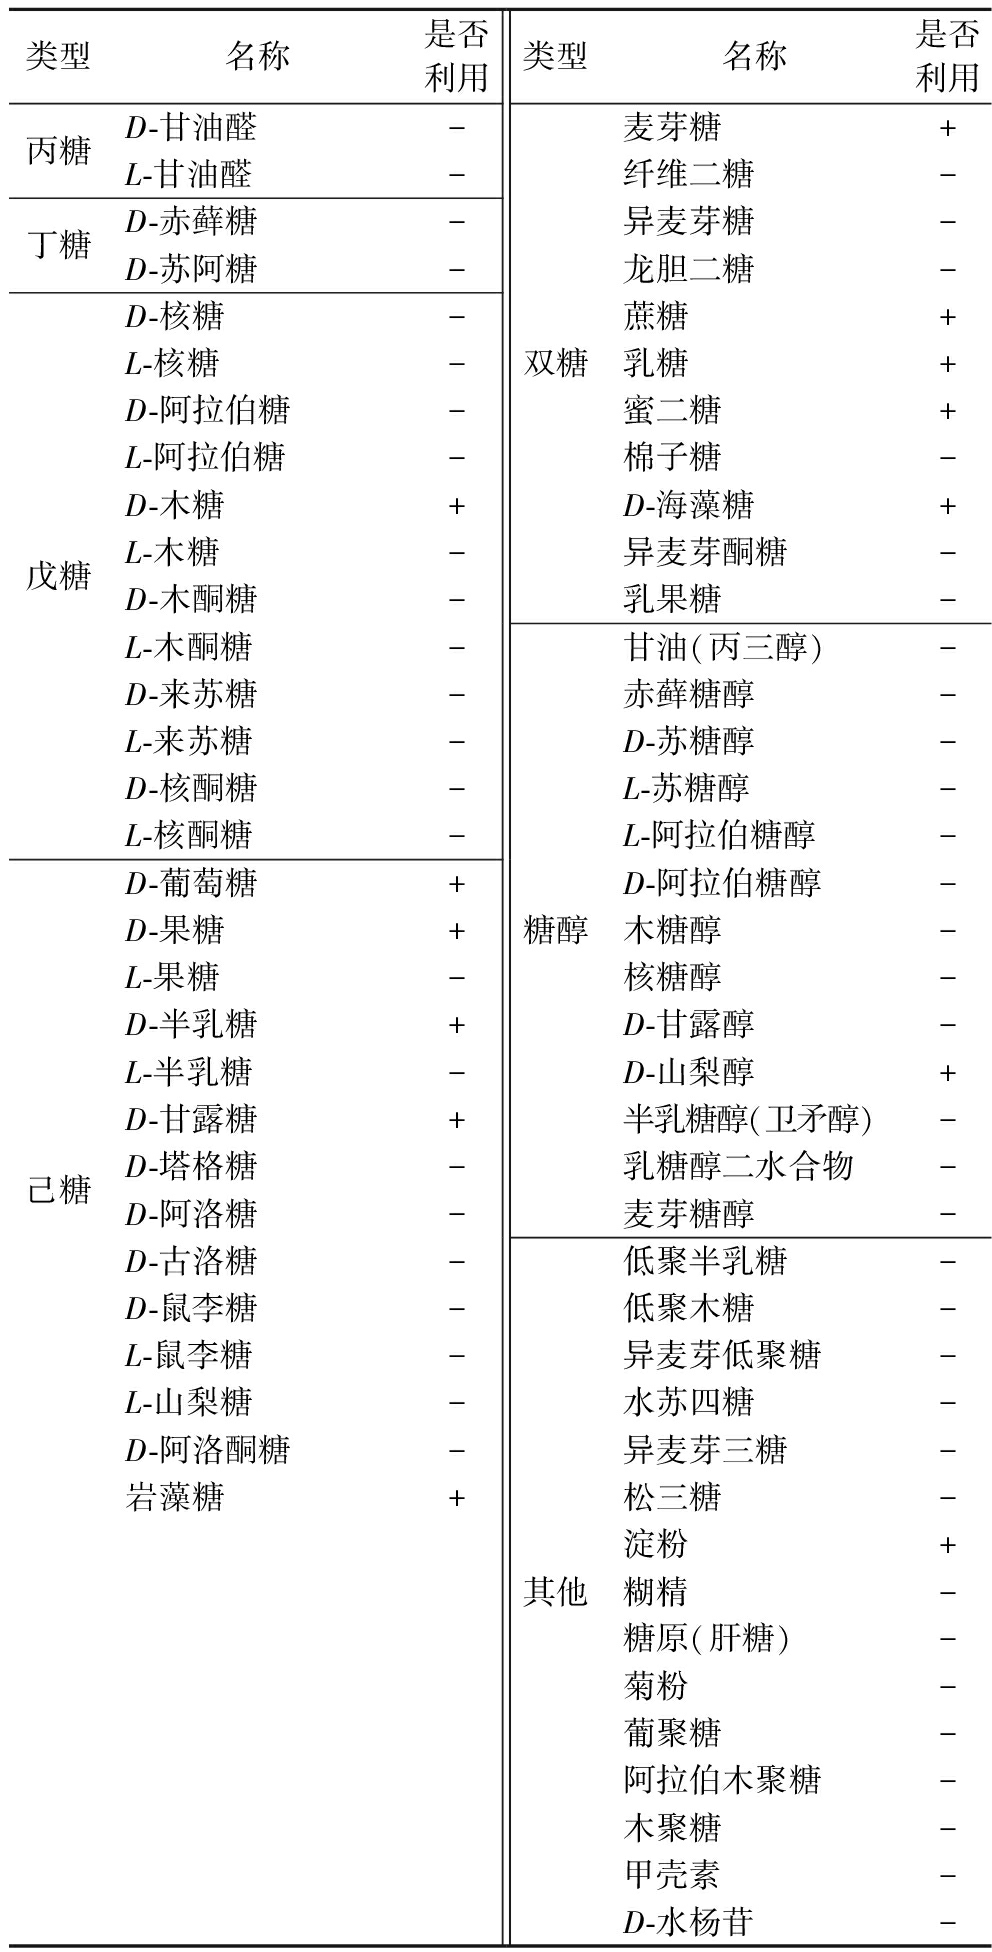
类型名称是否利用类型名称是否利用丙糖D-甘油醛-L-甘油醛-丁糖D-赤藓糖-D-苏阿糖-戊糖D-核糖-L-核糖-D-阿拉伯糖-L-阿拉伯糖-D-木糖+L-木糖-D-木酮糖-L-木酮糖-D-来苏糖-L-来苏糖-D-核酮糖-L-核酮糖-己糖D-葡萄糖+D-果糖+L-果糖-D-半乳糖+L-半乳糖-D-甘露糖+D-塔格糖-D-阿洛糖-D-古洛糖-D-鼠李糖-L-鼠李糖-L-山梨糖-D-阿洛酮糖-岩藻糖+双糖麦芽糖+纤维二糖-异麦芽糖-龙胆二糖-蔗糖+乳糖+蜜二糖+棉子糖-D-海藻糖+异麦芽酮糖-乳果糖-糖醇甘油(丙三醇)-赤藓糖醇-D-苏糖醇-L-苏糖醇-L-阿拉伯糖醇-D-阿拉伯糖醇-木糖醇-核糖醇-D-甘露醇-D-山梨醇+半乳糖醇(卫矛醇)-乳糖醇二水合物-麦芽糖醇-其他低聚半乳糖-低聚木糖-异麦芽低聚糖-水苏四糖-异麦芽三糖-松三糖-淀粉+糊精-糖原(肝糖)-菊粉-葡聚糖-阿拉伯木聚糖-木聚糖-甲壳素-D-水杨苷-
注:“+”表示可利用;“-”表示不可利用。
这些碳源显著富集于TCA循环以及糖酵解途径,氨基酸合成、核苷酸合成等途径。这一方面与菌株已知的厌氧发酵特性相符,证明了模型预测的生物学一致性;另一方面也揭示了该菌株在不同碳源上可能具备尚未被开发的潜在价值。
3 结论与讨论
本研究成功构建了高质量脆弱拟杆菌基因组规模代谢网络模型iBF628,经评估验证后准确率达81%,模型经memote评估得分达到88.45。将其应用于碳源利用潜力的大规模预测,结果可以筛选出D-木糖、D-葡萄糖、D-甘露糖、麦芽糖、蜜二糖等17种可利用的碳源,表明该菌株具备代谢多种糖类、糖醇及其他碳源的广泛能力。为后续在不同碳源条件下开展代谢特征的实验验证提供了理论依据和候选方向。未来研究可通过整合组学数据、酶动力学参数和底物结构特异性信息,进一步提升模型对多糖类碳源预测的准确性,随着更多实验数据的引入,所建立的代谢模型有望不断完善,从而在解析脆弱拟杆菌碳源适应策略方面发挥更大的指导作用,并进一步减少实验筛选过程中的盲目性和工作量。
[1] Nikitina A S, Kharlampieva D D, Babenko V V, et al.Complete genome sequence of an enterotoxigenic Bacteroides fragilis clinical isolate[J].Genome Announcements, 2015,3(3):e00450-e00415.
[2] Patrick S.A tale of two habitats:Bacteroides fragilis, a lethal pathogen and resident in the human gastrointestinal microbiome[J].Microbiology, 2022, 168(4):001156.
[3] Tufail M A, Schmitz R A.Exploring the probiotic potential of bacteroides spp.within one health paradigm[J].Probiotics and Antimicrobial Proteins, 2025, 17(2):681-704.
[4] Shagaleeva O, Pobeguts O, Kashatnikova D, et al.Proteome profiling of intestinal cultures treated with Bacteroides fragilis vesicles revealed new mechanisms of anti-inflammatory response[J].Research Square, 2024.https://doi.org/10.21203/rs.3.rs-3970402/v1.
[5] Peng L Y, Li Z R, Green R S, et al.Butyrate enhances the intestinal barrier by facilitating tight junction assembly via activation of amp-activated protein kinase in Caco-2 cell monolayers12[J].The Journal of Nutrition, 2009, 139(9):1619-1625.
[6] Yang Y S, Cao X J, Kato N, et al.Gut Bacteroides fragilis in health and diseases:An updated review[J].Journal of Future Foods, 2027,7(1):10-21.
[7] He Q Y, Niu M, Bi J D, et al.Protective effects of a new generation of probiotic Bacteroides fragilis against colitis in vivo and in vitro[J].Scientific Reports, 2023, 13:15842.
[8] Vaezijoze S, Irani S, Siadat S D, et al.Modulation of satiety hormones by Bacteroides thetaiotaomicron, Bacteroides fragilis and their derivatives[J].AMB Express, 2025, 15(1):41.
[9] Donaldson G P, Ladinsky M S, Yu K B, et al.Gut microbiota utilize immunoglobulin A for mucosal colonization[J].Science, 2018, 360(6390):795-800.
[10] Chan J L, Wu S G, Geis A L, et al.Non-toxigenic Bacteroides fragilis (NTBF) administration reduces bacteria-driven chronic colitis and tumor development independent of polysaccharide A[J].Mucosal Immunology, 2019, 12(1):164-177.
[11] Hansen C H F, Jozipovic D, Zachariassen L F, et al.Probiotic treatment with viable α-galactosylceramide-producing Bacteroides fragilis reduces diabetes incidence in female nonobese diabetic mice[J].Journal of Diabetes, 2024, 16(8):e13593.
[12] Roustapoor R, Abdi E, Khabbaz A, et al.The metabolic and immunomodulatory functions of Bacteroides fragilis;a next-generation probiotic?[J].Medicine in Microecology, 2025, 25:100137.
[13] Rios-Covian D, Cuesta I, Alvarez-Buylla J R, et al.Bacteroides fragilis metabolises exopolysaccharides produced by bifidobacteria[J].BMC Microbiology, 2016, 16(1):150.
[14] 周静茹, 刘鹏, 夏建业, 等.基于约束的基因组规模代谢网络模型构建方法研究进展[J].生物工程学报, 2021, 37(5):1526-1540.Zhou J R, Liu P, Xia J Y, et al.Advances in the development of constraint-based genome-scale metabolic network models[J].Chinese Journal of Biotechnology, 2021, 37(5):1526-1540.
[15] Neal M, Thiruppathy D, Zengler K.Genome-scale metabolic modeling of the human gut bacterium Bacteroides fragilis strain 638R[J].PLOS Computational Biology, 2023, 19(10):e1011594.
[16] Brettin T, Davis J J, Disz T, et al.RASTtk:A modular and extensible implementation of the RAST algorithm for building custom annotation pipelines and annotating batches of genomes[J].Scientific Reports, 2015, 5:8365.
[17] Zimmermann J, Kaleta C, Waschina S.gapseq:Informed prediction of bacterial metabolic pathways and reconstruction of accurate metabolic models[J].Genome Biology, 2021, 22(1):81.
[18] 陈鑫珠, 董朝霞, 张建国.饲草附生乳酸菌对碳源的选择性[J].福建农业学报, 2024, 39(5):512-521.Chen X Z, Dong Z X, Zhang J G.Silage carbon sources preferred by epiphytic lactic acid bacteria[J].Fujian Journal of Agricultural Sciences, 2024, 39(5):512-521.
[19] Tatka L T, Smith L P, Hellerstein J L, et al.Adapting modeling and simulation credibility standards to computational systems biology[J].Journal of Translational Medicine, 2023, 21(1):501.